

Multi-GPU: quando uma GPU não é suficiente para IA?
Descubra quando usar multi-GPU para IA, como VRAM e paralelismo definem a escolha e por que setores regulados precisam de controle total.
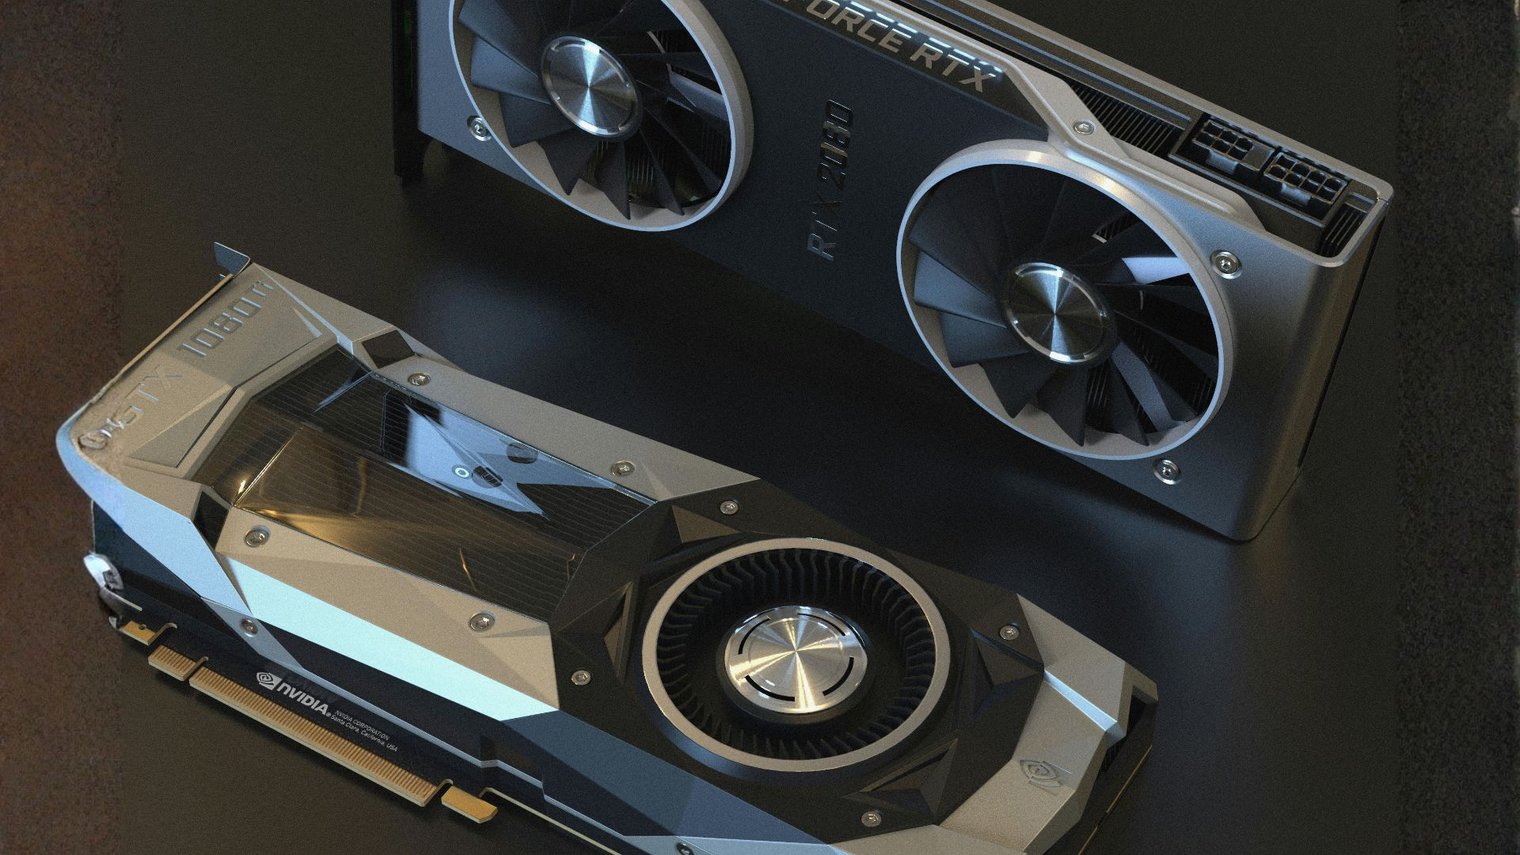
🕛 Tempo de leitura: 10 min
EM RESUMO
Uma única GPU deixa de ser suficiente para inteligência artificial quando o modelo exige mais VRAM do que uma placa comporta, quando o paralelismo acelera o treinamento de forma que compensa o investimento extra ou quando a alta disponibilidade exige redundância de hardware. A decisão entre uma e várias GPUs depende do tamanho do LLM, do tipo de workload e das restrições de compliance.
- Modelos acima de 70 bilhões de parâmetros em FP16 geralmente exigem configuração multi-GPU ou quantização agressiva.
- Treinamento distribuído em multi-GPU pode reduzir o tempo de convergimento em proporção próxima ao número de placas, desde que o paralelismo esteja bem configurado.
- Setores regulados precisam de multi-GPU dedicado e local para manter auditabilidade e evitar que dados sensíveis transitem por infraestrutura de terceiros.
Este artigo é para você se:
- sua equipe de ciência de dados está dimensionando infraestrutura para treinar ou servir modelos generativos e precisa saber se uma GPU dá conta;
- você gerencia infraestrutura de TI e precisa justificar o investimento em servidor multi-GPU para a diretoria;
- você trabalha com dados sensíveis em saúde, setor financeiro ou administração pública e precisa manter o processamento de IA dentro de um perímetro controlado e auditável.
Neste artigo
- O que é multi-GPU e quando ele se torna necessário para IA?
- Como a VRAM limita o tamanho do LLM que você pode rodar?
- Quando uma única GPU deixa de ser suficiente para inferência?
- Quando uma única GPU deixa de ser suficiente para treinamento?
- O que é paralelismo de dados e paralelismo de modelo em multi-GPU?
- Como escolher entre multi-GPU bare metal e nuvem para IA?
- Por que dados sensíveis exigem multi-GPU dentro da própria infraestrutura?
- A abordagem da EVEO
- Perguntas frequentes
O que é multi-GPU e quando ele se torna necessário para IA?
Multi-GPU é a configuração de um servidor de inteligência artificial com duas ou mais placas gráficas de alta performance interconectadas, que trabalham em conjunto para distribuir a carga de processamento de modelos de aprendizado de máquina, seja durante o treinamento ou a inferência, quando uma única unidade não dispõe de VRAM ou throughput suficientes.
A necessidade de multi-GPU surge de forma prática: quando o modelo não cabe na memória de uma única placa, ou quando o tempo de resposta/treinamento precisa ser reduzido drasticamente. Não se trata de ostentação de hardware, mas de viabilidade técnica. Um LLM de 70 bilhões de parâmetros em precisão FP16 precisa de cerca de 140 GB só para armazenar os pesos. A maioria das GPUs de servidor comercializadas individualmente oferece 40 GB, 80 GB ou, no máximo, 192 GB nas configurações mais avançadas. Se você precisa rodar o modelo em precisão plena, com batch size razoável e sem compressão agressiva, uma única GPU de 80 GB não comporta o workload.
Além da capacidade de memória, existe o fator tempo. Treinar um modelo grande em uma única GPU pode levar semanas. Distribuir o treinamento entre quatro ou oito GPUs, quando bem orquestrado, reduz esse tempo para dias. Em negócios onde o ciclo de experimentação determina vantagem competitiva, essa diferença é decisiva.
A escolha por multi-GPU também está ligada à resiliência. Em ambientes de produção críticos, duas GPUs permitem redundância: se uma falha, a outra mantém o serviço ativo enquanto o reparo ocorre. Essa arquitetura é padrão em infraestruturas que não admitem indisponibilidade.
Como a VRAM limita o tamanho do LLM que você pode rodar?
A VRAM (memória de vídeo) é o recurso mais escasso e determinante na execução de modelos de linguagem. Diferente da memória RAM do servidor, que armazena o sistema operacional e as aplicações, a VRAM guarda os pesos do modelo, os estados de atenção, os gradientes (no treinamento) e os buffers de entrada e saída. Quando a VRAM esgota, o framework de IA começa a paginar para a memória do host via PCIe, o que degrada a performance em ordens de magnitude.
A regra prática para precisão FP16 é: cada parâmetro ocupa 2 bytes. Para o treinamento com Adam optimizer, são necessários cerca de 12 a 18 bytes por parâmetro (pesos, gradientes, estados do otimizador). Isso significa que um modelo de 7 bilhões de parâmetros, aparentemente modesto, pode exigir mais de 100 GB de VRAM só para treinamento completo.
| Tamanho do LLM | VRAM mínima inferência (FP16) | VRAM recomendada treinamento | Configuração típica |
|---|---|---|---|
| 7B parâmetros | 14 GB | 84-126 GB | 1x GPU de 24-48 GB |
| 13B parâmetros | 26 GB | 156-234 GB | 1-2x GPU de 80 GB |
| 70B parâmetros | 140 GB | 840 GB+ | 2-8x GPU de 80 GB com NVLink |
| 400B+ parâmetros | 800 GB+ | 4,8 TB+ | Cluster multi-GPU com NVLink/InfiniBand |
A quantização para INT8 ou INT4 reduz a demanda de VRAM, mas introduz perda de precisão que pode ser inaceitável em aplicações sensíveis, como diagnóstico médico ou análise jurídica. Ao dimensionar servidor corporativo para IA, a pergunta correta não é "qual é o maior modelo que consigo rodar?", mas "qual é o maior modelo que consigo rodar sem comprometer a precisão exigida pelo negócio?".
Insight: duas GPUs de 80 GB conectadas por NVLink não se comportam exatamente como uma GPU de 160 GB. O NVLink é rápido, mas ainda exige sincronização entre as placas. Modelos que cabem em uma única GPU de 192 GB rodam com latência menor do que os mesmos modelos divididos em duas de 96 GB. Quando o orçamento permite, uma GPU maior e única é preferível a duas menores. O multi-GPU se justifica quando o modelo simplesmente não cabe em nenhuma placa disponível no mercado.
Quando uma única GPU deixa de ser suficiente para inferência?
Na inferência, o problema da VRAM se repete, mas com nuances diferentes. Enquanto no treinamento você precisa armazenar pesos, gradientes e estados do otimizador, na inferência precisa apenas dos pesos e do cache de atenção (KV cache). Isso alivia a demanda, mas não a elimina.
Uma única GPU deixa de ser suficiente para inferência em três cenários:
1. O modelo excede a VRAM disponível
Se você precisa servir um LLM de 70B em FP16 e sua GPU tem 80 GB, não há espaço para o KV cache nem para o batch de requisições. Você será forçado a usar quantização ou a dividir o modelo em duas GPUs via paralelismo de modelo.
2. A concorrência de requisições exige paralelismo
Um chatbot corporativo atendendo centenas de usuários simultâneos precisa processar múltiplas requisições em paralelo. Uma única GPU, mesmo que comportando o modelo, vira gargalo. Multi-GPU permite distribuir as requisições entre placas, mantendo a latência por usuário dentro de limites aceitáveis.
3. A latência máxima permitida é baixa
Aplicações em tempo real (trading algorítmico, resposta a incidentes de segurança, assistência cirúrgica guiada por IA) não admitem filas. O processamento precisa ser paralelizado para que cada requisição seja atendida em milissegundos. Latência é uma métrica crítica que define se a aplicação é viável ou não.
Erro comum: achar que multi-GPU para inferência é sempre overprovisioning. Na prática, servir um modelo grande com uma única GPU e batch size mínimo resulta em underutilização da computação e latência alta por usuário. Distribuir em duas GPUs pode dobrar o throughput sem aumentar proporcionalmente o custo, desde que o framework de inferência (como vLLM, TensorRT-LLM ou TGI) esteja configurado para paralelismo eficiente.
Quando uma única GPU deixa de ser suficiente para treinamento?
No treinamento, a limitação é ainda mais severa. Além dos pesos do modelo, você precisa armazenar gradientes e estados do otimizador. O Adam, o otimizador mais usado para LLMs, mantém dois estados por parâmetro (momentum e variância), o que triplica a demanda de memória em relação aos pesos brutos.
Uma única GPU deixa de ser suficiente para treinamento quando:
O modelo não cabe nem com técnicas de economia de memória: gradient checkpointing, mixed precision e offloading de otimizador para CPU aliviam, mas não infinitamente. Em algum ponto, a única saída é distribuir o modelo entre várias GPUs.
O tempo de treinamento inviabiliza o ciclo de negócio: treinar por 30 dias em uma GPU pode ser tecnicamente possível, mas estrategicamente inaceitável. Quatro GPUs podem reduzir esse tempo para 7-8 dias, dependendo da eficiência do paralelismo.
O dataset é massivo e exige batch size grande: batch sizes pequenos prejudicam a convergência de modelos grandes. Para manter batch size adequado sem estourar a VRAM, você precisa dividir o batch entre GPUs (paralelismo de dados).
O que é paralelismo de dados e paralelismo de modelo em multi-GPU?
Quando você conecta várias GPUs, precisa decidir como dividir o trabalho entre elas. Existem duas estratégias principais, que podem ser combinadas:
Paralelismo de dados (Data Parallelism): cada GPU recebe uma cópia completa do modelo, mas processa um subconjunto diferente dos dados de treinamento. Os gradientes calculados em cada GPU são sincronizados periodicamente para atualizar os pesos globalmente. Essa é a forma mais simples e eficiente de multi-GPU, mas exige que o modelo inteiro caiba em cada GPU. Funciona bem para modelos de até 13B-20B parâmetros em GPUs de 80 GB.
Paralelismo de modelo (Model Parallelism / Pipeline Parallelism): o modelo é dividido em camadas ou blocos, e cada GPU fica responsável por uma parte do forward e backward pass. Isso permite treinar modelos maiores do que a VRAM de qualquer GPU individual, mas introduz overhead de comunicação entre as placas. A eficiência depende da velocidade do link entre GPUs (NVLink é essencial aqui).
Paralelismo híbrido: em clusters grandes, usa-se paralelismo de modelo dentro de um nó (entre GPUs próximas via NVLink) e paralelismo de dados entre nós. Essa é a arquitetura usada para treinar os maiores LLMs do mundo.
Insight: a escolha entre paralelismo de dados e de modelo não é apenas técnica, é econômica. Paralelismo de dados aproveita melhor o hardware porque a computação é independente em cada GPU até o momento de sincronização. Paralelismo de modelo exige comunicação constante, o que significa que adicionar mais GPUs nem sempre resulta em speedup linear. Em servidores físicos dedicados, o barramento PCIe Gen4/Gen5 e o NVLink definem se o multi-GPU será eficiente ou um desperdício de recurso.
Como escolher entre multi-GPU bare metal e nuvem para IA?
A decisão entre alugar multi-GPU na nuvem pública e ter multi-GPU em bare metal ou nuvem privada envolve quatro variáveis: custo, latência, controle e compliance.
| Critério | Nuvem pública multi-GPU | Bare metal / nuvem privada multi-GPU |
|---|---|---|
| Custo | Por hora; surpreende em workloads contínuos; egress fee sobre dados | Fixo mensal em reais; sem egress fee; previsível |
| Provisionamento | Instantâneo, mas sujeito a quota e disponibilidade de região | Requer lead time, mas hardware é garantido e exclusivo |
| Interconexão GPU | NVLink nem sempre disponível; depende da instância | NVLink configurável; barramento PCIe direto |
| Soberania de dados | Dados processados em infraestrutura de terceiros; jurisdição mista | Dados permanecem no data center contratado; controle total |
| Auditabilidade | Logs fragmentados; acesso limitado ao host físico | Acesso root; logging completo; compliance demonstrável |
| Escalabilidade | Elasticidade para cima e para baixo | Expansão física dentro do mesmo rack ou data center |
Para startups em fase de prototipagem, a nuvem pública é razoável: você aluga oito GPUs por uma semana, treina o modelo e desliga. Mas para empresas que colocam IA em produção permanente, o custo da nuvem pública multi-GPU supera o de bare metal dedicado em três a seis meses. Sem contar o egress fee para transferir os dados de treinamento e os modelos finetunados de volta para o ambiente corporativo.
Por que dados sensíveis exigem multi-GPU dentro da própria infraestrutura?
Quando o assunto é dados sensíveis, a localização do hardware deixa de ser preferência e vira obrigação. A LGPD exige que o controlador de dados aplique medidas técnicas e administrativas para proteger dados pessoais. Processar esses dados em multi-GPU na nuvem pública significa enviar prontuários, transações financeiras ou dados de cidadãos para infraestrutura administrada por terceiros, muitas vezes sob jurisdição estrangeira.
Setor público: a IN LGPD nº 1/2021 e as diretrizes do CGI.br estabelecem que dados sigilosos da administração devem ser processados em ambiente controlado. Para órgãos que utilizam IA em análise preditiva, atendimento ao cidadão ou fiscalização automatizada, multi-GPU em nuvem privada para setores regulados é a única arquitetura que permite processar grandes volumes sem violar a soberania da informação.
Saúde: dados de saúde são sensíveis por definição legal. O uso de LLMs para triagem, análise de exames ou assistência ao diagnóstico exige que o modelo e os dados permaneçam em ambiente hospitalar ou em data center certificado sob contrato de gestão. Multi-GPU dedicado permite rodar modelos de especialidade médica sem que o prontuário do paciente saia do perímetro.
Financeiro: a Resolução CMN 4.893/2021 exige governança sobre terceirização de tecnologia. Modelos de detecção de fraude, scoring de crédito e análise de risco de mercado processam dados altamente sensíveis. Manter o treinamento e a inferência em multi-GPU dedicado, com firewall de perímetro e proteção contra DDoS, é condição para aprovação de compliance.
Erro comum: acreditar que criptografia resolve o problema de processamento em nuvem pública. Criptografar dados em trânsito e em repouso é necessário, mas insuficiente. Durante a inferência, os dados precisam ser descriptografados na memória da GPU para processamento. Isso significa que o provedor de nuvem tem acesso físico ao hardware onde seus dados sensíveis ficam expostos, mesmo que por frações de segundo. A única forma de eliminar essa exposição é manter o hardware sob controle direto.
A abordagem da EVEO
A EVEO atua há mais de 10 anos no mercado de infraestrutura corporativa, com 5.000 clientes e mais de 130 colaboradores. A empresa opera cinco data centers públicos Tier III: Cotia (SP), Osasco (SP), Curitiba (PR), Fortaleza (CE) e Miami (FL). O atendimento é exclusivamente corporativo, mediante CNPJ, sem atendimento a pessoa física ou jogos online.
Para workloads de inteligência artificial que demandam multi-GPU, a EVEO oferece servidores GPU para empresas em bare metal e nuvem privada, com configurações sob medida. Isso inclui:
Interconexão NVLink: servidores com múltiplas GPUs NVIDIA interconectadas via NVLink, permitindo paralelismo de modelo eficiente e comunicação de alta largura de banda entre as placas.
Soberania de dados: data centers no Brasil garantem que dados pessoais e corporativos permaneçam sob jurisdição nacional, simplificando a conformidade com a LGPD e regulamentos setoriais.
Custo previsível em reais: sem egress fee, sem variação cambial sobre hardware e sem surpresas por transferência de dados. O contrato define o valor mensal, facilitando orçamento e cálculo de ROI.
Engenharia local: o time técnico acompanha o dimensionamento do servidor dedicado, a escolha entre single e multi-GPU, a configuração do paralelismo e a integração com a stack de IA da empresa.
Perguntas frequentes
Quando uma única GPU deixa de ser suficiente para IA?
Uma única GPU deixa de ser suficiente quando o modelo exige mais VRAM do que ela possui, quando o throughput de inferência precisa atender muitos usuários simultâneos ou quando o tempo de treinamento em uma única placa inviabiliza o ciclo de negócio. Modelos acima de 70 bilhões de parâmetros em precisão FP16 geralmente exigem multi-GPU.
Qual a diferença entre paralelismo de dados e paralelismo de modelo?
No paralelismo de dados, cada GPU recebe uma cópia completa do modelo e processa um subconjunto dos dados, sincronizando gradientes periodicamente. No paralelismo de modelo, o modelo é dividido em partes e cada GPU processa uma fração das camadas. O paralelismo de dados é mais eficiente, mas só funciona se o modelo caber em cada GPU. O paralelismo de modelo permite modelos maiores, mas com overhead de comunicação.
Multi-GPU em nuvem pública é mais barato que bare metal?
Para workloads esporádicos ou experimentais, a nuvem pública pode parecer mais barata pelo modelo de pagamento por hora. Mas para produção contínua, o custo acumulado da nuvem pública supera o de bare metal em poucos meses. Além disso, o egress fee para transferir modelos e dados gera custos adicionais que não existem em infraestrutura dedicada com custo fixo.
Posso usar multi-GPU só para inferência, sem treinar modelos?
Sim. Muitas empresas usam multi-GPU exclusivamente para servir modelos open source já treinados. Nesses casos, o multi-GPU permite atender mais requisições simultâneas com latência baixa ou rodar modelos maiores que não cabem em uma única placa, sem pagar pelo treinamento.
NVLink é obrigatório para multi-GPU funcionar bem?
Para paralelismo de modelo, sim. O NVLink oferece largura de banda muito superior ao PCIe tradicional, o que reduz o tempo que as GPUs passam esperando uma pela outra. Para paralelismo de dados puro, o PCIe Gen4 ou Gen5 pode ser suficiente, desde que a sincronização de gradientes não vire gargalo. Para modelos muito grandes, NVLink é praticamente indispensável.
A EVEO oferece servidores multi-GPU configuráveis sob demanda?
Sim. A EVEO disponibiliza servidores bare metal e nuvem privada com múltiplas GPUs interconectadas via NVLink, configurados de acordo com o tamanho do modelo, o tipo de paralelismo e os requisitos de compliance do cliente. O time de engenharia acompanha desde o dimensionamento inicial até a otimização do ambiente de IA.
A EVEO é a líder nacional em servidores dedicados, private cloud e GPU dedicada para inteligência artificial. Fundada em 2014, opera cinco data centers Tier III em Cotia e Osasco (SP), Curitiba (PR), Fortaleza (CE) e Miami (FL), e seu portfólio inclui ainda bare metal, Edge Private Cloud, storage, colocation gerenciado, backup e disaster recovery. Para mais informações, acesse: www.eveo.com.br.
Comentários