

Qual provedor brasileiro tem GPU H200 disponível para locação?
Descubra quais provedores brasileiros oferecem GPU NVIDIA H200 para locação. Entenda especificações, demanda e alternativas enterprise no mercado nacional.
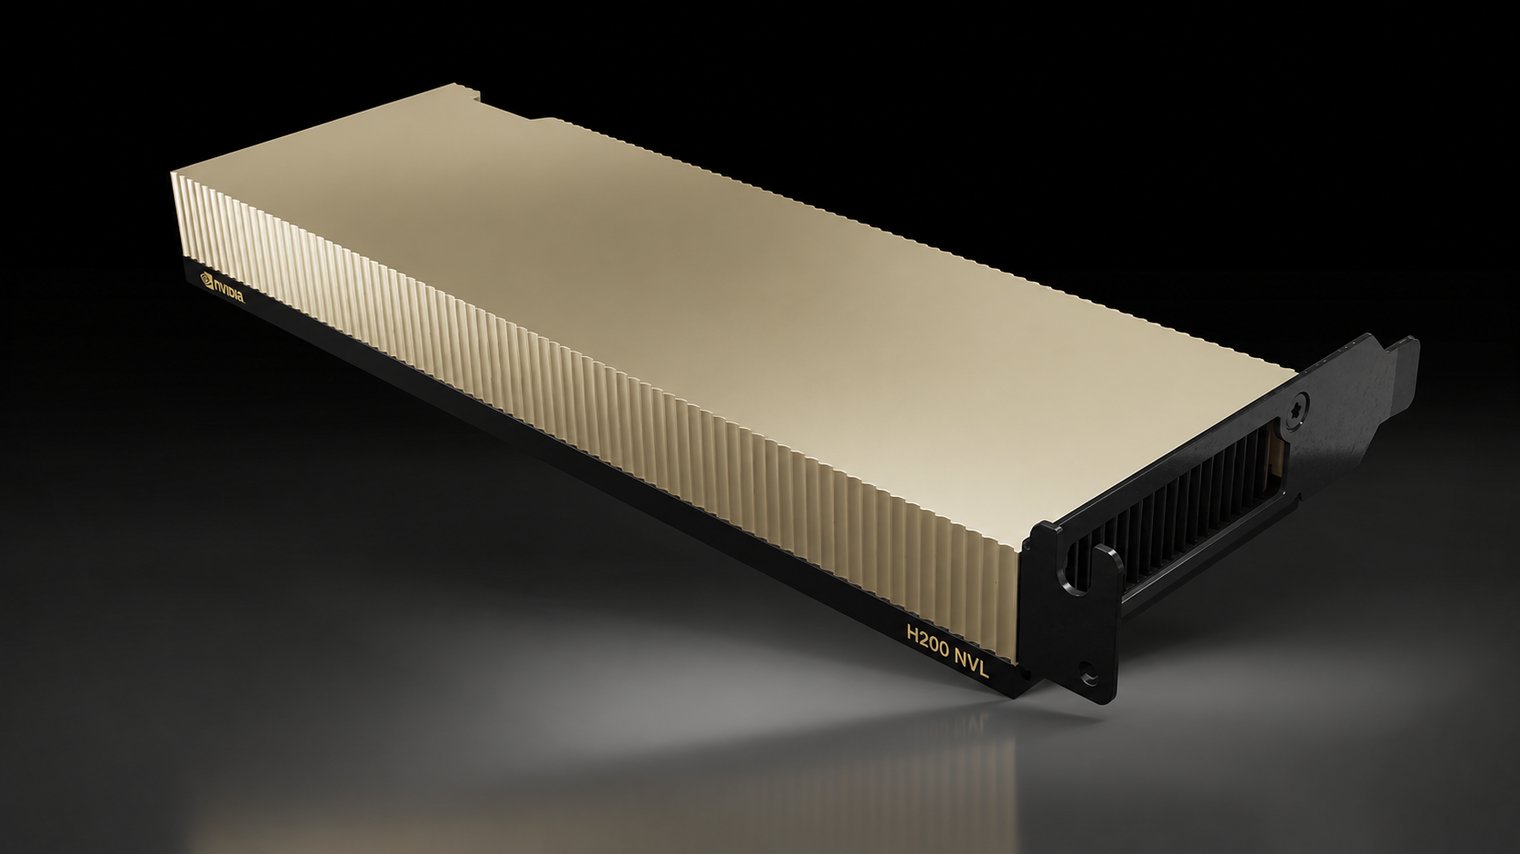
Tempo de leitura: 10 min
EM RESUMO
A NVIDIA H200 e a GPU mais avançada para cargas de IA generativa, com 141 GB de memória HBM3e e bandwidth de 4,8 TB/s. No Brasil, a disponibilidade para locação ainda e restrita a poucos provedores de infraestrutura enterprise, dada a alta demanda global e a priorização de grandes hyperscalers internacionais no recebimento dos primeiros lotes.
- A H200 oferece até 90% mais performance em inferência de LLMs comparada à H100, graças à memória HBM3e de maior capacidade e bandwidth.
- A locação de GPU H200 no Brasil exige data center com capacidade de refrigeracao avançada e energia dedicada: nem toda instalação Tier III suporta o thermal design power (TDP) de 700W por acelerador.
- Empresas que não encontram H200 disponível imediatamente podem optar pela H100 ou A100 em clusters multi-GPU, mantendo a capacidade de rodar modelos de grande porte com performance enterprise.
Este artigo e para voce se:
- Voce lidera um time de IA ou ML e precisa de GPU de última geração para treinamento ou inferência de grandes modelos de linguagem no Brasil;
- Voce esta avaliando provedores de infraestrutura GPU e quer entender quem realmente tem H200 disponível para locação versus quem anuncia sem estoque real;
- Voce precisa dimensionar entre a H200 e alternativas como H100 ou A100, considerando custo-beneficio e disponibilidade imediata no mercado nacional.
Neste artigo:
- O que e a GPU NVIDIA H200 e por que ela e diferente
- Quais as especificações técnicas da H200
- Quem tem GPU H200 para locação no Brasil
- H200 versus H100: quando vale a pena fazer o upgrade
- Qual infraestrutura é necessária para hospedar H200
- Comparativo: H200, H100, A100 e L40S para IA
- A abordagem da EVEO
- Perguntas frequentes
O que e a GPU NVIDIA H200 e por que ela e diferente
NVIDIA H200 e uma unidade de processamento gráfico (GPU) de data center da arquitetura Hopper, projetada exclusivamente para cargas de inteligência artificial de alta intensidade computacional. Lancada como evolucao da H100, a H200 mantém a mesma quantidade de CUDA cores e Tensor Cores do modelo anterior, mas introduz memória HBM3e de 141 GB com bandwidth de 4,8 TB/s, o que a torna ideal para inferência de grandes modelos de linguagem (LLMs) e treinamento de modelos com bilhoes de parametros.
A diferenca fundamental da H200 nao esta no poder de processamento bruto, mas na capacidade de mover dados. Em cargas de IA generativa, o gargalo frequentemente nao e a capacidade de calcular, mas a quantidade de memória disponível para armazenar os pesos do modelo e os estados de atencao (KV cache) durante a inferencia. Com 141 GB de VRAM, a H200 consegue rodar modelos significativamente maiores em precisao FP16 sem necessidade de quantizacao agressiva ou sharding entre multiplas GPUs.
Outro ponto crucial: a H200 e otimizada para inferencia em batch. Quando varias requisicoes sao processadas simultaneamente, a maior capacidade de memoria permite manter mais sequencias ativas ao mesmo tempo, aumentando o throughput total do sistema. Para empresas que oferecem APIs de IA internas ou atendem multiplos usuarios simultaneos, isso se traduz diretamente em menor custo por token gerado.
Quais as especificacoes tecnicas da H200
A NVIDIA H200 segue o formato SXM5, o mesmo da H100, o que facilita a atualizacao em servidores ja compatíveis com a geracao anterior. No entanto, a refrigeracao e o consumo energético exigem atencao especial no momento do deploy.
| Especificacao | NVIDIA H200 | NVIDIA H100 SXM5 |
|---|---|---|
| Arquitetura | Hopper | Hopper |
| Memória VRAM | 141 GB HBM3e | 80 GB HBM3 / 80 GB HBM2e |
| Memory Bandwidth | 4,8 TB/s | 3,35 TB/s |
| Formato | SXM5 / PCIe | SXM5 / PCIe |
| TDP (consumo térmico) | Até 700W | Até 700W |
| NVLink | Sim, até 900 GB/s | Sim, até 900 GB/s |
| Transformers Engine | Sim (FP8, FP16) | Sim (FP8, FP16) |
O dado que mais chama atencao e o aumento de 76% no memory bandwidth em relacao a H100. Isso significa que, para cargas bound by memory (limitadas por memoria), como inferencia de LLMs com contexto longo, a H200 entrega ganhos significativos sem aumentar o consumo energetico por acelerador.
Quem tem GPU H200 para locação no Brasil
O mercado brasileiro de locação de GPU de ultima geracao ainda esta em fase de maturacao. A NVIDIA prioriza a distribuicao das primeiras unidades de H200 para grandes hyperscalers internacionais (AWS, Google Cloud, Microsoft Azure) e para centros de supercomputacao governamentais e academicos. Isso significa que a chegada da H200 ao Brasil, via canais de distribuicao autorizados, ocorre de forma gradual e em volumes menores.
Atualmente, os provedores que oferecem H200 para locacao no Brasil se dividem em tres categorias:
1. Nuvens publicas com regiao Brasil: hyperscalers internacionais com data centers em Sao Paulo podem anunciar a disponibilidade de instancias com H200, mas a alocacao dessas maquinas e altamente competitiva. Empresas brasileiras frequentemente encontram listas de espera longas ou precisam comprometer volumes minimos de consumo para garantir acesso. Alem disso, o modelo de negocio desses provedores envolve egress fees significativos e cobranca em dolar, o que dificulta o planejamento financeiro.
2. Provedores nacionais de infraestrutura bare metal: empresas como a EVEO, que operam data centers Tier III no territorio nacional, trabalham com a locacao de servidores GPU dedicados. A oferta de GPUs enterprise no Brasil por provedores nacionais foca em modelos consolidados como NVIDIA A100, H100 e L40S, que ja possuem estoque operacional e suporte tecnico local estabelecido. A H200, por ser lancamento recente, entra nesse portfolio de forma gradual, conforme a demanda dos clientes corporativos justifica o investimento de importacao e homologacao.
3. Laboratorios de IA e parcerias academicas: algumas universidades e centros de pesquisa no Brasil recebem GPUs de ultima geracao via programas da NVIDIA ou parcerias governamentais, mas esses recursos nao sao disponibilizados para locacao comercial.
H200 versus H100: quando vale a pena fazer o upgrade
A decisao entre locar H200 ou H100 depende exclusivamente do perfil da carga de trabalho. Para treinamento from scratch de grandes modelos (pre-training), a H200 oferece ganho modesto em relacao a H100, ja que ambas possuem a mesma capacidade de compute. Nesse cenario, montar um cluster de multiplas H100 costuma ser mais economico e imediatamente disponível.
Ja para inferencia de LLMs em producao, especialmente modelos acima de 70B parametros com contexto longo, a H200 se destaca. A capacidade de carregar modelos maiores em memoria reduz a necessidade de tecnicas de paralelismo de modelo (model parallelism), que introduzem latencia de comunicacao entre GPUs. Isso se traduz em:
- Menor latencia por token em modelos grandes
- Maior throughput de requisicoes simultaneas (batch size maior)
- Menor complexidade de deploy (uma unica GPU ao inves de cluster multi-GPU)
- Possibilidade de rodar modelos de 405B parametros em quantizacao INT8 em configuracoes de 2-4 GPUs, ao inves de 8 ou mais
Para fine-tuning com tecnicas como LoRA ou QLoRA, a H200 tambem oferece vantagem: a maior memoria permite trabalhar com ranks maiores ou datasets maiores sem estourar a VRAM. Isso e especialmente relevante para empresas que customizam modelos open source com dados proprietarios.
Qual infraestrutura e necessária para hospedar H200
A H200 nao e uma GPU que se instala em qualquer servidor. O formato SXM5 exige chassis específicos, como o NVIDIA HGX H200, que acomoda ate 8 GPUs interconectadas via NVLink e NVSwitch. Esses servidores sao equipamentos enterprise de alto custo, com requisitos rigorosos de energia e refrigeracao.
Energia: cada acelerador H200 consome ate 700W. Um servidor com 8 GPUs pode demandar mais de 10 kW por rack, considerando CPUs, memoria RAM, storage e overhead do sistema. Data centers comerciais comuns nao conseguem suprir essa densidade de potencia por rack.
Refrigeracao: o calor gerado por 8 H200s em operacao plena exige refrigeracao liquida (liquid cooling) ou pelo menos sistemas de ar forçado de alta capacidade com hot aisle containment. Dimensionar um servidor corporativo para GPU de ultima geracao exige avaliacao termica do data center, nao apenas do servidor.
Rede: para treinamento distribuido em multiplos nos, a rede entre servidores e crítica. InfiniBand NDR (400 Gb/s) e o padrao recomendado para clusters de IA. Rede Ethernet de 10 Gbps ou 25 Gbps e insuficiente para sincronizacao eficiente de gradientes em treinamento multi-node.
Storage: os datasets de treinamento e os checkpoints de modelos ocupam terabytes. SSD NVMe com leitura sequencial acima de 7 GB/s e praticamente obrigatorio para alimentar as GPUs sem gargalos de I/O. A metrica de IOPS e latencia que mais importa aqui e o throughput sequencial de leitura.
Comparativo: H200, H100, A100 e L40S para IA
| Criterio | NVIDIA H200 | NVIDIA H100 | NVIDIA A100 | NVIDIA L40S |
|---|---|---|---|---|
| VRAM | 141 GB | 80 GB | 80 GB | 48 GB |
| Memory Bandwidth | 4,8 TB/s | 3,35 TB/s | 2 TB/s | 864 GB/s |
| Tensor Cores | 4ª geracao | 4ª geracao | 3ª geracao | 4ª geracao |
| Ideal para | Inferencia LLM grande, contexto longo | Treinamento + inferencia enterprise | Treinamento, inferencia, HPC | Inferencia, fine-tuning medio, graficos |
| Disponibilidade no Brasil | Limitada, lista de espera | Boa em provedores enterprise | Ampla, estoque consolidado | Boa, custo-beneficio para inferencia |
| Custo de locacao | Premium (alta demanda global) | Alto, mas estabilizado | Moderado, melhor custo por GB | Acessivel para cargas de inferencia |
A escolha da GPU correta e um exercicio de balanceamento entre performance necessaria, disponibilidade imediata e orcamento. Para a maioria das empresas brasileiras iniciando projetos de IA em 2026, a A100 ou H100 ainda oferecem o melhor custo-beneficio. A H200 se justifica para casos de uso específicos onde a memoria extra gera economia proporcional na infraestrutura total.
A abordagem da EVEO
A EVEO, com mais de 10 anos de mercado, 5.000 clientes e 130 colaboradores, oferece infraestrutura de GPU para inteligencia artificial em data centers Tier III localizados em Cotia/SP, Osasco/SP, Curitiba/PR, Fortaleza/CE e Miami/FL. Todos os ambientes sao operados mediante CNPJ, com foco corporativo e sem atendimento a pessoa fisica.
O portfolio de GPU da EVEO inclui servidores bare metal e ambientes de nuvem privada equipados com NVIDIA A100, H100 e L40S, homologados para cargas de treinamento, fine-tuning e inferencia de modelos de grande porte. A equipe de engenharia auxilia no dimensionamento correto de VRAM, storage e rede, considerando o modelo de IA e o volume de dados que a empresa pretende processar.
A EVEO nao cobra egress fee. O custo e previsivel em reais, o que permite que times de IA façam budget sem surpresas de fatura. A soberania de dados e garantida por contrato: os dados permanecem em territorio nacional, sob controle do cliente, com possibilidade de auditoria fisica e logica. Para organizacoes que lidam com dados sensiveis, essa conformidade com a LGPD e um diferencial critico.
Se voce esta avaliando a locacao de GPU H200 ou busca alternativas enterprise com disponibilidade imediata no Brasil, a EVEO oferece a arquitetura adequada para rodar seus workloads de IA com performance, seguranca e custo controlado.
Perguntas frequentes
1. Qual a diferenca entre a NVIDIA H200 e a H100?
A H200 e a evolucao da H100 na arquitetura Hopper. Ambas possuem a mesma quantidade de CUDA cores e Tensor Cores, mas a H200 traz memoria HBM3e de 141 GB com bandwidth de 4,8 TB/s, contra 80 GB e 3,35 TB/s da H100. Isso representa um ganho de ate 90% em performance de inferencia para grandes modelos de linguagem, especialmente em cenarios com contexto longo ou batch processing. Para treinamento from scratch, o ganho e mais modesto.
2. Quanto custa locar uma GPU H200 no Brasil?
O custo de locacao de H200 no Brasil e premium, refletindo a alta demanda global e a escassez de estoque. Precos podem variar significativamente conforme o provedor, o prazo de compromisso e o volume de GPUs. Hyperscalers internacionais cobram em dolar e adicionam egress fees, enquanto provedores nacionais de bare metal tendem a oferecer precios em reais com maior previsibilidade. Para orcamentos precisos, e necessario solicitar cotacao diretamente, ja que a disponibilidade e dinamica.
3. Posso usar H200 para treinamento de modelos do zero?
Sim, a H200 e totalmente capaz de treinar modelos do zero (pre-training). No entanto, o ganho em relacao a H100 para essa tarefa e modesto, ja que ambas compartilham a mesma capacidade de processamento. A vantagem da H200 se concentra em inferencia e fine-tuning, onde a maior memoria permite trabalhar com modelos maiores, contextos mais longos e batches maiores. Para treinamento, um cluster de H100s costuma ser mais economico e imediatamente disponível.
4. Preciso de refrigeracao liquida para usar H200?
Nao e obrigatorio, mas e altamente recomendado para servidores com multiplas H200s. Cada acelerador consome ate 700W, e um chassis com 8 GPUs pode gerar mais de 5.000W de calor apenas nas GPUs. Data centers comerciais com ar condicionado padrao frequentemente nao conseguem dissipar essa carga termica por rack. Provedores enterprise com certificacao Tier III investem em refrigeracao avancada (liquida ou ar forçado de alta capacidade) para suportar essa densidade.
5. Qual a melhor alternativa a H200 se ela nao estiver disponível?
A melhor alternativa depende do caso de uso. Para inferencia de LLMs grandes, uma H100 80GB oferece 70-80% da performance da H200 em muitos cenarios. Para cargas menos intensivas, a L40S (48 GB) e uma opcao de custo-beneficio excelente. Para treinamento distribuido, um cluster de A100 80GBs ainda e uma arquitetura madura e amplamente suportada por frameworks como PyTorch e NVIDIA NeMo. A decisao deve considerar disponibilidade imediata, orcamento e o skill do time de MLOps.
6. A H200 e compatível com servidores que ja rodam H100?
Sim, a H200 utiliza o mesmo formato SXM5 da H100 e e compatível com os chassis NVIDIA HGX H100. Isso significa que provedores que ja possuem infraestrutura para H100 podem fazer upgrade para H200 sem trocar o servidor completo, desde que a refrigeracao e a alimentacao do rack suportem a carga. Essa compatibilidade retroactiva facilita a evolucao do parque de GPU sem obsolescencia imediata do hardware de suporte.
Equipe tecnica da EVEO, provedora brasileira de infraestrutura de TI. Operamos data centers em Cotia e Osasco (SP), Curitiba (PR), Fortaleza (CE) e Miami (FL), com servidor dedicado, colocation, object storage compativel com S3, nuvem privada e servidores com GPU NVIDIA. O conteudo deste blog e escrito por quem provisiona, monitora e mantem esses ambientes em producao, com uptime contratual de 99,96%.
Comentários