

Quanta VRAM um LLM precisa para rodar localmente?
Veja quanta VRAM seu LLM precisa para rodar localmente. Tabela com Llama, DeepSeek, Qwen e as melhores GPUs dedicadas.
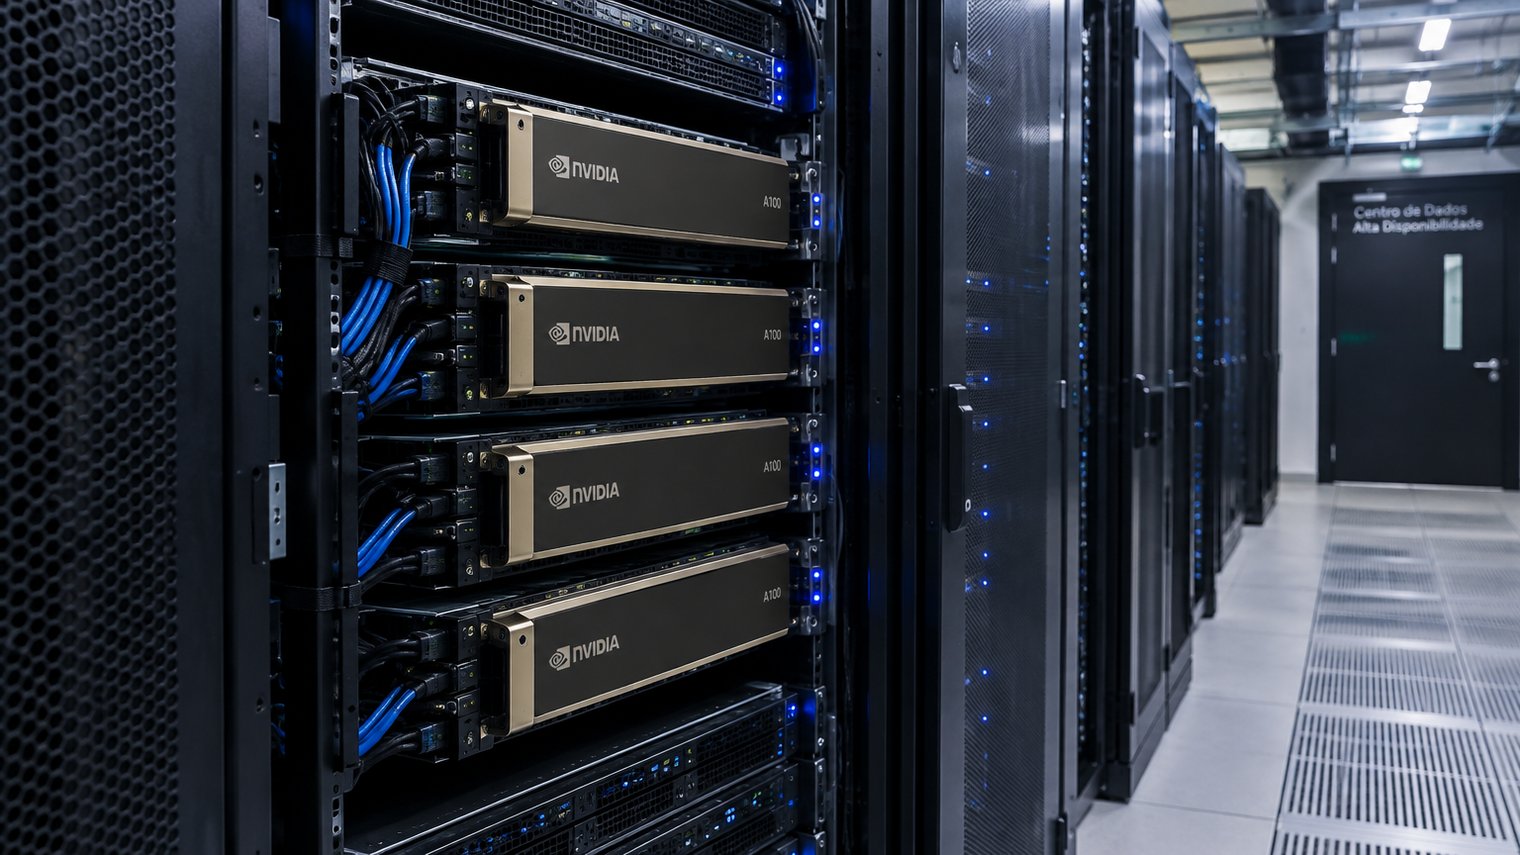
Tempo de leitura: 11 min
EM RESUMO
Para rodar um LLM localmente, o consumo de VRAM varia entre 0,55 GB por bilhão de parâmetros em quantização Q4 (4 bits) e 2 GB por bilhão em FP16 nativo (16 bits), somando-se a isso a reserva mandatória para o KV cache e ativações de contexto. Na prática, um modelo compacto de 7B a 8B parâmetros em Q4 opera com estabilidade em 8 GB a 16 GB de VRAM, enquanto arquiteturas densas de 70B ou modelos MoE demandam de 48 GB a centenas de gigabytes. Para cargas corporativas contínuas, a infraestrutura dedicada com GPUs enterprise viabiliza essa operação com previsibilidade orçamentária e total isolamento dos dados.
- A quantização Q4 reduz a exigência de memória em até 75% frente ao ponto flutuante padrão, mantendo alta fidelidade analítica em inferência produtiva;
- Modelos médios (14B a 32B) exigem entre 10 GB e 24 GB de VRAM para janelas moderadas de contexto, demandando GPUs profissionais da classe NVIDIA RTX A5000 ou A6000;
- Modelos de grande escala (Llama 70B, Qwen 72B e variantes destiladas do DeepSeek-R1) exigem instâncias enterprise bare metal com aceleradores NVIDIA A100 ou H100.
Este artigo é para você se:
- Sua equipe de engenharia precisa dimensionar a VRAM exata para hospedar modelos open-weight internamente sem gargalos de inferência;
- Sua empresa opera dados regulados e precisa substituir APIs públicas por um ambiente de IA local aderente às diretrizes da LGPD;
- Busca entender como a linha de servidores dedicados e nuvem privada com a GPU da EVEO elimina os custos imprevistos de tráfego de dados.
Neste artigo
- O que é VRAM para LLM e como dimensionar a capacidade necessária?
- Como a quantização altera o consumo de VRAM e a fidelidade da inferência?
- Tabela comparativa: modelos, quantizações e GPUs.
- Modelos Llama: quanto de memória de vídeo cada versão exige?
- Modelos DeepSeek: quais variantes rodam em servidor dedicado?
- Família Qwen: requisitos técnicos e limites de contexto
- Mistral e Gemma: alternativas compactas para alta eficiência operacional
- Como selecionar o hardware ideal para inferência de alta performance?
- A abordagem da EVEO
- Perguntas frequentes
O que é VRAM para LLM e como dimensionar a capacidade necessária?
VRAM para LLM é a memória física de alta largura de banda integrada à placa gráfica, utilizada para carregar os pesos estáticos dos modelos de linguagem neural, processar tensores intermediários e sustentar o armazenamento volátil do KV cache durante a geração de respostas. A capacidade total de VRAM determina diretamente a extensão do contexto comportado e o limite paramétrico executável.
O cálculo de capacidade de memória gráfica não se limita ao volume estático ocupado pelo arquivo de pesos no disco. Quando um modelo processa requisições contínuas, três elementos centrais competem pelo espaço na VRAM da placa:
- Pesos do modelo: correspondem à multiplicação pura do número total de parâmetros pelo número de bytes alocados por precisão (por exemplo, 2 bytes no formato FP16 ou 0,55 byte em Q4).
- KV Cache (Key-Value Cache): estrutura de memória volátil que preserva o histórico de atenção dos tokens já computados na sessão. Seu crescimento é linear e contínuo: quanto maior a janela de tokens requisitada pelo usuário, maior o espaço de memória exigido.
- Buffers de ativação e runtime: espaço de manobra alocado pelo CUDA, drivers e motores de inferência (vLLM, TGI, llama.cpp) para a multiplicação de matrizes densas em tempo de execução.
Para um planejamento realista de infraestrutura empresarial, adota-se a fórmula empírica de dimensionamento seguro:
VRAM Requerida (GB) ≈ [Parâmetros (B) × Bytes por peso] × Margem de Sobrecarga (1,20 a 1,35)
Em ambientes com múltiplos acessos simultâneos, o KV cache pode facilmente consumir mais memória do que os próprios pesos estáticos do modelo. Compreender essa proporção é essencial para saber o que considerar ao escolher um servidor GPU para empresas, prevenindo o temido erro de memória esgotada (CUDA Out of Memory).
Erro comum: dimensionar o servidor observando unicamente o peso do arquivo baixado. Se um modelo consome 14 GB de espaço estático e é implementado em uma GPU de 16 GB, qualquer prompt extenso ou entrada de múltiplos usuários gerará travamento imediato por exaustão do KV cache. Reserve sempre uma margem técnica mínima de 20% a 30%.
Como a quantização altera o consumo de VRAM e a fidelidade da inferência?
Quantização é o processo matemático de mapear tensores de alta precisão contínua em representações numéricas discretas de menor bit rate. Ao converter os pesos de precisões tradicionais de 16 bits (FP16 ou BF16) para formatos comprimidos de 8 bits (INT8/Q8) ou 4 bits (INT4/Q4_K_M), reduz-se o volume de memória necessário para carregar o modelo sem a necessidade de descartar camadas da rede neural.
No ecossistema corporativo, a quantização Q4 consolidou-se como o padrão técnico para viabilizar inferência local de alta densidade. Ela consome aproximadamente 28% da memória necessária em FP16, viabilizando que modelos com alto poder de discernimento operem com baixa latência em servidores dedicados de custo controlado.
Insight operacional: a degradação de acurácia associada aos esquemas modernos de quantização (como Q4_K_M ou AWQ) é praticamente desprezível para aplicações de processamento de documentos, sumarização e análise semântica. Implementar um modelo maior de 32B quantizado em 4 bits oferece respostas estruturalmente superiores às de um modelo menor de 7B mantido em ponto flutuante total (FP16).
Tabela comparativa
Abaixo, detalhamos o perfil de consumo de memória de vídeo dos principais modelos de código aberto do mercado, cruzando as demandas técnicas com as arquiteturas de servidores dedicados físicos e ambientes de nuvem privada fornecidos pela EVEO em seus data centers nacionais certificados.
| Modelo | Parâmetros | VRAM (Q4) | VRAM (Q8) | VRAM (FP16) | GPU indicado |
|---|---|---|---|---|---|
| Llama 3.2 3B | 3B | ~2,2 GB | ~4,0 GB | ~7,5 GB | Instância GPU Entry-level com NVIDIA RTX A4000 (16 GB) |
| Gemma 3 4B | 4B | ~3,0 GB | ~5,2 GB | ~9,8 GB | Instância GPU Entry-level com NVIDIA RTX A4000 (16 GB) |
| Mistral 7B | 7B | ~5,2 GB | ~9,0 GB | ~17,5 GB | Servidor Dedicado GPU com NVIDIA RTX A4000 / A5000 (24 GB) |
| Llama 3.1 8B | 8B | ~5,8 GB | ~10,2 GB | ~19,5 GB | Servidor Dedicado GPU com NVIDIA RTX A4000 / A5000 (24 GB) |
| DeepSeek-R1 Distill 7B | 7B | ~5,5 GB | ~9,8 GB | ~18,5 GB | Servidor Dedicado GPU com NVIDIA RTX A4000 / A5000 (24 GB) |
| Qwen 2.5 / 3 7B | 7B | ~5,3 GB | ~9,5 GB | ~18,0 GB | Servidor Dedicado GPU com NVIDIA RTX A4000 / A5000 (24 GB) |
| DeepSeek-R1 Distill 14B | 14B | ~10,5 GB | ~18,2 GB | ~35,0 GB | Servidor GPU Mid-range com RTX A6000 (48 GB) ou A100 (40 GB) |
| Qwen 2.5 / 3 14B | 14B | ~10,5 GB | ~18,2 GB | ~35,0 GB | Servidor GPU Mid-range com RTX A6000 (48 GB) ou A100 (40 GB) |
| Gemma 3 27B | 27B | ~18,5 GB | ~34,0 GB | ~66,0 GB | Servidor GPU Mid-range com NVIDIA RTX A6000 (48 GB) |
| DeepSeek-R1 Distill 32B | 32B | ~22,5 GB | ~41,0 GB | ~78,0 GB | Servidor GPU Enterprise com NVIDIA RTX A6000 ou A100 (80 GB) |
| Qwen 2.5 / 3 32B | 32B | ~22,5 GB | ~41,0 GB | ~78,0 GB | Servidor GPU Enterprise com NVIDIA RTX A6000 ou A100 (80 GB) |
| Llama 3.1 70B | 70B | ~43,0 GB | ~82,0 GB | ~165,0 GB | Servidor Bare Metal Enterprise com NVIDIA A100 (80 GB) ou H100 |
| Qwen 2.5 / 3 72B | 72B | ~45,0 GB | ~85,0 GB | ~170,0 GB | Servidor Bare Metal Enterprise com NVIDIA A100 (80 GB) ou H100 |
| DeepSeek-R1 Distill 70B | 70B | ~43,0 GB | ~82,0 GB | ~165,0 GB | Servidor Bare Metal Enterprise com NVIDIA A100 (80 GB) ou H100 |
| Llama 4 Scout (MoE) | 109B total (17B ativos) |
~58,0 GB | ~115,0 GB | ~230,0 GB | Cluster Multi-GPU com 2x A100 (80 GB) ou H100 NVLink |
| DeepSeek V3 / V4 (MoE Full) | 671B total (37B ativos) |
~390,0 GB | ~720,0 GB | ~1.450,0 GB | Cluster Bare Metal Customizado com 8x NVIDIA H100 (80 GB) |
Modelos Llama: quanto de memória de vídeo cada versão exige?
A arquitetura Llama é a fundação do ecossistema de código aberto. Os modelos menores, como o Llama 3.2 3B e o Llama 3.1 8B, tornaram-se referências técnicas para pipelines de automação, triagem de chamados e sumarização estruturada de dados internos.
Para hospedar o Llama 3.1 8B em sua totalidade funcional com quantização Q4, é necessária uma reserva prática de 8 GB a 10 GB de VRAM para suportar requisições concorrentes. Uma máquina configurada com a GPU NVIDIA RTX A4000 de 16 GB oferece estabilidade completa para essa carga em servidores bare metal, sem riscos de gargalos durante picos de chamada.
O Llama 3.1 70B, por outro lado, exige capacidade profissional superior. Mesmo com compressão agressiva em Q4, a alocação mínima parte de 43 GB. Tentativas de particionar essa carga em placas consumer conectadas via barramento PCIe tradicional resultam em perda severa de vazão de tokens. O tráfego exige GPUs da categoria NVIDIA A100 ou H100, interconectadas em servidores configurados para suportar transferências massivas.
Modelos DeepSeek: quais variantes rodam em servidor dedicado?
O ecossistema DeepSeek gerou grande repercussão técnica com o lançamento do DeepSeek-R1 e de suas versões base V3 e V4. No entanto, é mandatório separar o modelo base completo de suas versões destiladas:
- Versões destiladas (Distill 7B, 14B e 32B): construídas sobre esqueletos estruturais do Qwen e Llama, essas versões mantêm a metodologia de raciocínio lógico profundo, mas com peso paramétrico acessível. O modelo de 14B roda com alto desempenho em um servidor configurado com NVIDIA RTX A6000 de 48 GB, com ampla folga para janelas longas de contexto.
- DeepSeek-R1 Distill 70B: demanda um nó de computação equipado com uma GPU NVIDIA A100 de 80 GB ou duas placas RTX A6000 associadas para operar em precisão Q4 e Q8.
- DeepSeek V3 / V4 e R1 Full (671B MoE): modelos completos com arquitetura de especialistas distribuídos (Mixture of Experts). Eles demandam a carga de todos os parâmetros na memória ativa, exigindo clusters bare metal multi-GPU com aceleradores interligados por barramentos de altíssima velocidade.
Atenção técnica: arquiteturas MoE ativam apenas uma fração dos parâmetros por token gerado, porém todos os pesos precisam estar obrigatoriamente mapeados na VRAM. O ganho dos modelos MoE reside na velocidade de inferência (tempo até o primeiro token e geração por segundo), e não na economia de capacidade física de memória.
Família Qwen: requisitos técnicos e limites de contexto
Desenvolvidos com foco balanceado em tarefas de raciocínio, codificação e compreensão multilíngue profunda, os modelos da série Qwen (notadamente Qwen 2.5 e Qwen 3) ocupam posições de destaque técnico em avaliações corporativas. O Qwen 14B e o Qwen 32B destacam-se como soluções altamente eficazes para automação de tarefas em dados corporativos confidenciais.
Um diferencial crítico da família Qwen é o suporte nativo a contextos estendidos (até 128K tokens). No entanto, ativar essa janela em ambiente produtivo altera drasticamente o consumo de VRAM. Uma instância do Qwen 32B operando em Q4_K_M requer cerca de 22,5 GB apenas para os pesos; expandir a sessão para 32K tokens eleva a demanda para além de 38 GB de memória.
Por essa razão, a alocação desse modelo para casos de uso corporativos contínuos é recomendada em servidores dedicados com aceleradores NVIDIA A100 de 80 GB. Essa infraestrutura previne a contenção de recursos e assegura a sustentação de fluxos de trabalho avançados como RAG (Retrieval-Augmented Generation) sobre bases de conhecimento empresariais.
Mistral e Gemma: alternativas compactas para alta eficiência operacional
Nem toda aplicação de IA generativa corporativa exige dezenas de bilhões de parâmetros. Para pipelines voltados a classificação de chamados, estruturação de dados desestruturados e geração de resumos pontuais, modelos compactos representam a melhor relação entre custo computacional e rendimento.
O Mistral 7B revolucionou a inferência rápida graças à implementação do mecanismo Sliding Window Attention, reduzindo o consumo de memória do KV cache sem prejudicar o contexto imediato. Ele opera de forma estável em instâncias com placas NVIDIA RTX A4000 (16 GB), deixando ampla margem para paralelismo de requisições sob custos contidos em reais.
A série Gemma 3, por sua vez, entrega alta densidade em suas versões de 4B e 27B parâmetros. O modelo Gemma 3 27B em precisão Q4 demanda cerca de 18,5 GB de VRAM, transformando a GPU corporativa NVIDIA RTX A6000 (48 GB) na plataforma perfeita para empresas que buscam alta performance de geração textual mantendo os dados totalmente isolados sob a Lei Geral de Proteção de Dados.
Como selecionar o hardware ideal para inferência de alta performance?
Dimensionar a infraestrutura de computação acelerada para inteligência artificial envolve balancear parâmetros além do volume bruto de VRAM. A largura de banda de memória (Memory Bandwidth) e o tipo de barramento determinam diretamente o tempo de resposta em ambientes multiusuário.
Ao planejar seu ambiente em servidores dedicados físicos ou nuvem privada, adote as seguintes diretrizes:
- Até 8B parâmetros (Inferência Rápida / Automação): modelos como Llama 3.1 8B, Qwen 7B e Mistral 7B em Q4 demandam servidores equipados com GPUs da série NVIDIA RTX A4000 (16 GB) ou A5000 (24 GB). Configuração econômica e de alta densidade operacional.
- De 14B a 32B parâmetros (Raciocínio Médio e Codificação): demandam placas da linha NVIDIA RTX A6000 (48 GB) ou A100 (40 GB PCIe). Permitem contextos estendidos e acomodam requisições paralelas sem risco de degradação.
- Modelos de 70B ou superior (Sistemas Analíticos de Alta Complexidade): demandam nós dedicados de alta performance (Bare Metal) com GPUs NVIDIA A100 (80 GB SXM) ou NVIDIA H100. Essas placas possuem larguras de banda superiores a 2.000 GB/s, acelerando drasticamente o processamento de tokens.
Para empresas que buscam máxima performance sem a sobrecarga de virtualização, entender a estrutura de um guia de servidores dedicados bare metal é o primeiro passo para garantir controle total sobre os aceleradores gráficos.
Vantagem Bare Metal: em ambientes virtualizados compartilhados, a contenção de barramento PCIe e o overhead do hipervisor podem degradar a vazão de inferência em até 20%. O acesso exclusivo à GPU em servidores dedicados garante tempo de resposta previsível e latência mínima em todas as chamadas à aplicação.
A abordagem da EVEO
Hospedar modelos de linguagem internamente exige confiabilidade física, segurança mandatória e previsibilidade orçamentária. Com mais de 10 anos de experiência consolidada no mercado corporativo, mais de 5.000 clientes e uma equipe técnica de mais de 130 colaboradores, a EVEO projeta e implementa ambientes sob medida para cargas intensivas de computação acelerada.
Nossa operação corporativa é conduzida por lideranças experientes do setor, sob a direção do CEO Lucas Vanzin e do Executive Chairman Vicente Neto, atendendo estritamente demandas empresariais mediante contrato formal com CNPJ. Disponibilizamos infraestrutura avançada de servidores bare metal e soluções em nuvem privada configuradas com os mais robustos aceleradores gráficos da NVIDIA, abrangendo desde a versátil RTX A4000 até clusters avançados com A100 e H100.
Toda essa capacidade computacional é sustentada por nossos 5 data centers públicos, rigorosamente certificados no padrão Tier III: Cotia/SP, Osasco/SP, Curitiba/PR, Fortaleza/CE e Miami/FL. Essa malha proporciona soberania absoluta dos dados corporativos em solo brasileiro, conformidade integral com os requisitos de auditoria da LGPD e conexão de altíssima velocidade.
Diferente de provedores de hiperescala internacionais, a EVEO adota um modelo comercial 100% transparente: custo estável faturado em reais, sem exposição à variação cambial e com a garantia de isenção total de taxas de transferência (sem egress fee). Seus dados e fluxos de IA trafegam sem custos ocultos por requisição.
Perguntas frequentes
1. Uma GPU de 8 GB consegue rodar um LLM de 7 bilhões de parâmetros em produção corporativa?
Não com confiabilidade para ambientes produtivos corporativos. Embora um modelo de 7B em quantização Q4 ocupe cerca de 5,2 GB estáticos na VRAM, uma GPU de 8 GB deixa margem insuficiente para o crescimento do KV cache em contextos longos ou concorrência de requisições. Para uso empresarial contínuo, a EVEO indica servidores equipados com GPUs a partir de 16 GB ou 24 GB, como a NVIDIA RTX A4000 ou A5000, assegurando estabilidade operacional sem travamentos.
2. Qual é a perda real de acurácia ao utilizar quantização Q4 em vez de FP16 nativo?
Em tarefas corporativas habituais como busca semântica, sumarização de documentos e extração de entidades, a perda de acurácia entre FP16 e esquemas modernos de quantização Q4 (como Q4_K_M ou AWQ) é inferior a 3% a 5% em índices de referência técnica. Em contrapartida, a economia de memória gráfica alcança quase 75%, permitindo que sua empresa utilize modelos de arquitetura mais complexa no mesmo orçamento de infraestrutura física.
3. O DeepSeek-R1 original pode ser executado em um único servidor GPU dedicado?
O modelo completo DeepSeek-R1 (versão MoE original de 671 bilhões de parâmetros) não pode ser executado em uma única GPU, pois demanda aproximadamente 390 GB de memória de vídeo mesmo comprimido em quantização Q4. Sua execução exige um cluster bare metal multi-GPU com aceleradores como NVIDIA H100 interligados via rede de baixa latência. No entanto, suas variantes destiladas de 14B e 32B operam com excelente performance em nós dedicados individuais da EVEO equipados com placas RTX A6000 ou A100.
4. Como o tamanho da janela de contexto impacta os requisitos de VRAM do servidor?
O histórico de atenção dos tokens processados é retido dinamicamente na VRAM em uma estrutura denominada KV cache. Conforme o contexto é expandido para analisar documentos extensos ou conversações longas, a memória consumida pelo KV cache pode dobrar a exigência de recursos do servidor em relação ao peso estático do modelo. Servidores corporativos da EVEO com GPUs de alta densidade (como A100 de 80 GB) oferecem a sustentação necessária para suportar janelas amplas sem gerar exceções de falta de memória.
5. É viável descarregar parte do modelo na memória RAM do sistema para economizar VRAM?
Tecnicamente sim, por meio de rotinas de CPU offload, mas a prática é inviável para aplicações corporativas interativas. A taxa de transferência de memórias RAM convencionais (DDR4 ou DDR5, variando de 30 a 100 GB/s) é incomparavelmente mais lenta do que a largura de banda de placas corporativas como a NVIDIA A100 (que atinge até 2.000 GB/s). Esse desnível gera gargalos massivos de processamento e eleva a latência a patamares inaceitáveis. O modelo deve residir integralmente na memória VRAM dedicada.
6. Quais vantagens a infraestrutura de GPU da EVEO oferece frente a serviços de IA em nuvem pública internacional?
A EVEO assegura soberania completa dos dados com armazenamento e processamento em data centers nacionais certificados Tier III, garantindo conformidade rigorosa com a LGPD e eliminando a exposição de dados sensíveis a jurisdições estrangeiras. Além disso, a EVEO não cobra tarifas de transferência de dados (egress fee) e pratica contratos em reais sem volatilidade cambial, proporcionando custos previsíveis e performance garantida por meio de servidores dedicados bare metal de uso corporativo exclusivo.
Equipe tecnica da EVEO, provedora brasileira de infraestrutura de TI. Operamos data centers em Cotia e Osasco (SP), Curitiba (PR), Fortaleza (CE) e Miami (FL), com servidor dedicado, colocation, object storage compativel com S3, nuvem privada e servidores com GPU NVIDIA. O conteudo deste blog e escrito por quem provisiona, monitora e mantem esses ambientes em producao, com uptime contratual de 99,96%.
Comentários